项目背景
项目背景与问题
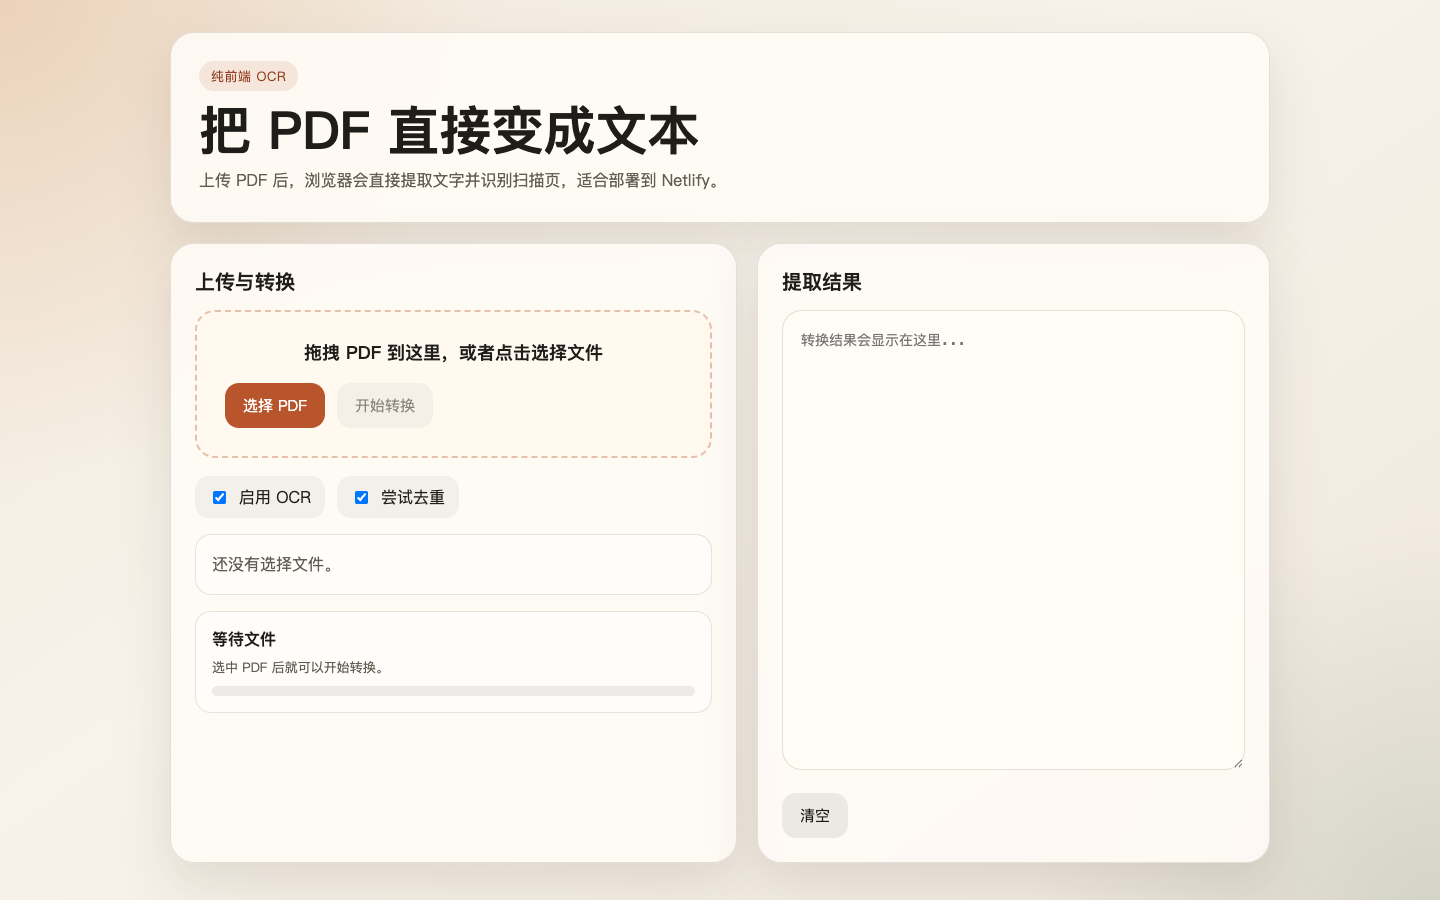
扫描讲义与教材资料常难以检索和二次编辑。这个前端工具提供不依赖服务器上传的基础转换流程。
核心功能
- PDF 原生文本提取
- 扫描页中英文 OCR
- 重复文本检测
- 结果清空与复制
教学与实验价值
- 降低扫描资料转写成本
- 便于后续建立可检索的课堂资料
- 文件在浏览器端处理
典型使用场景
- 扫描讲义转文本
- 教材资料归档
- 课堂素材整理
技术特点
- PDF.js
- Tesseract.js
- 浏览器端处理
后续规划
- 01补充 OCR 结果复核说明
- 02增加下载 TXT 与结构化导出
- 03补充大文件性能提示